OpenCLI:把网站变成 Agent 的 CLI
让 Agent 上网,常见做法有两种:写爬虫,或者让多模态模型看着浏览器点击。
前者维护成本高,每个网站都要处理登录、反爬、页面结构变化;后者慢且贵,每一步都要截图、识别、推理。OpenCLI 走的是第三条路:把网站变成 CLI。
项目地址在 jackwener/OpenCLI。它的目标是把网站、浏览器会话、Electron 应用和本地工具,统一成适合人和 Agent 使用的确定性接口。几个关键特点:
- 复用浏览器登录态:不需要手动复制 Cookie、拼请求头、把凭证硬编码进脚本;
- 命令在本地浏览器里执行:CLI 命令本身不经过大模型推理,不分析结果时运行成本为零;
- 输出结构化:支持 Markdown、CSV、JSON,方便接进知识库或数据分析流程;
- 确定性:同一个命令跑出来的结果结构一致,可管道、可脚本、可进 CI/CD。
它和“让大模型自己操作浏览器”最大的区别在于:CLI 命令是在本地浏览器里直接执行的,不经过大模型推理。 模型只负责决定“搜什么、下载什么、怎么整理”,执行交给命令。
OpenCLI 迭代得很快,下面的命令和界面以我使用的版本为准。遇到对不上的地方,优先看官方 README,不要硬套旧教程。
安装与连接
OpenCLI 通过 npm 安装,需要 Node.js >= 20.18.1:
node --version
npm install -g @jackwener/opencli
然后安装浏览器桥接插件。OpenCLI 通过一个轻量扩展连接 Chrome/Chromium,复用你已有的登录态。插件可以从 Chrome 应用商店安装,也可以手动加载解压后的扩展目录。
安装完成后检查连接:
opencli doctor
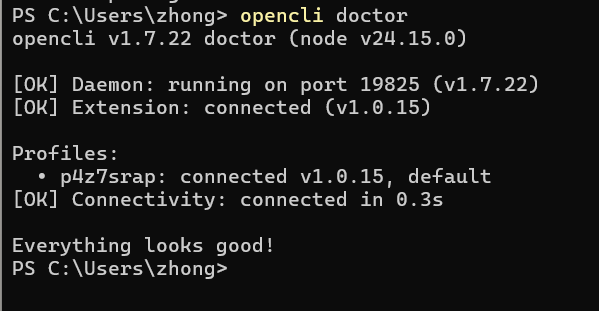
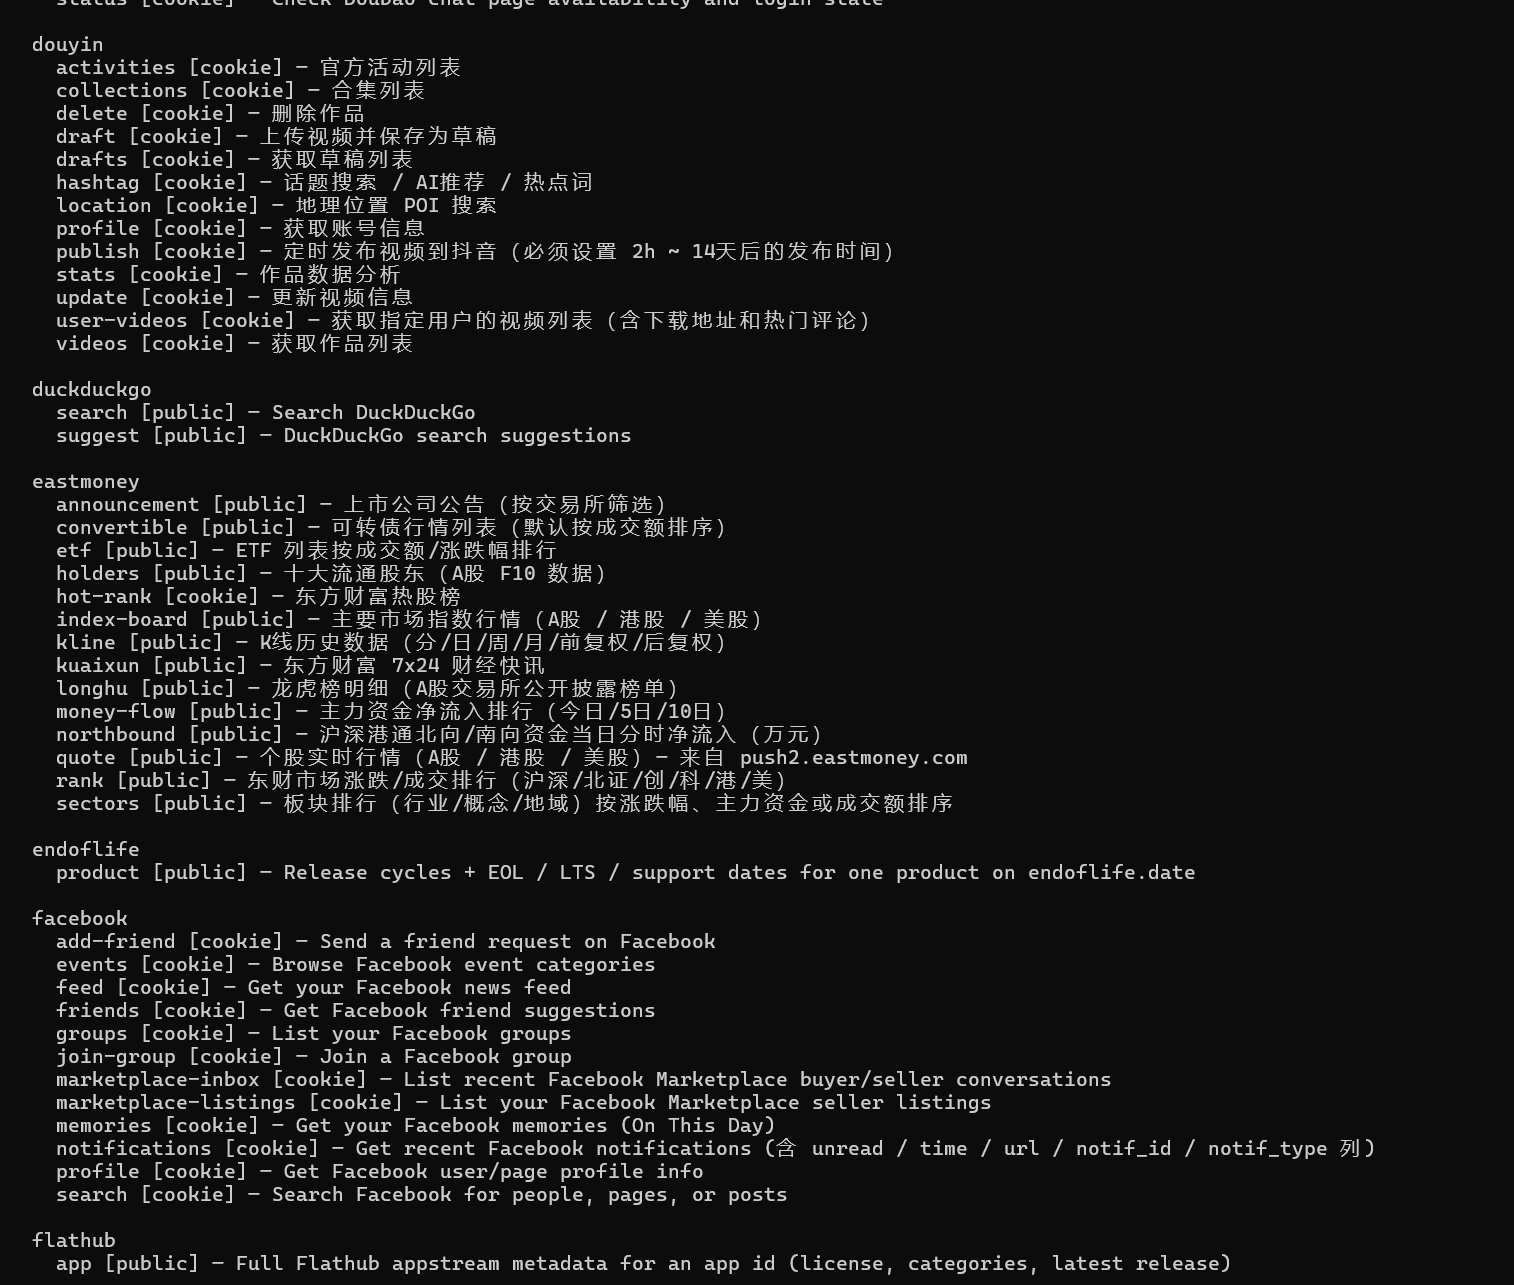
如果在多个浏览器或 Chrome 配置里装了插件,终端会提示你选择。连接正常后,用 opencli list 查看当前支持的命令和站点。
常用命令
不同版本的命令略有差异,下面是我常用的几类:
# 查看所有命令
opencli list

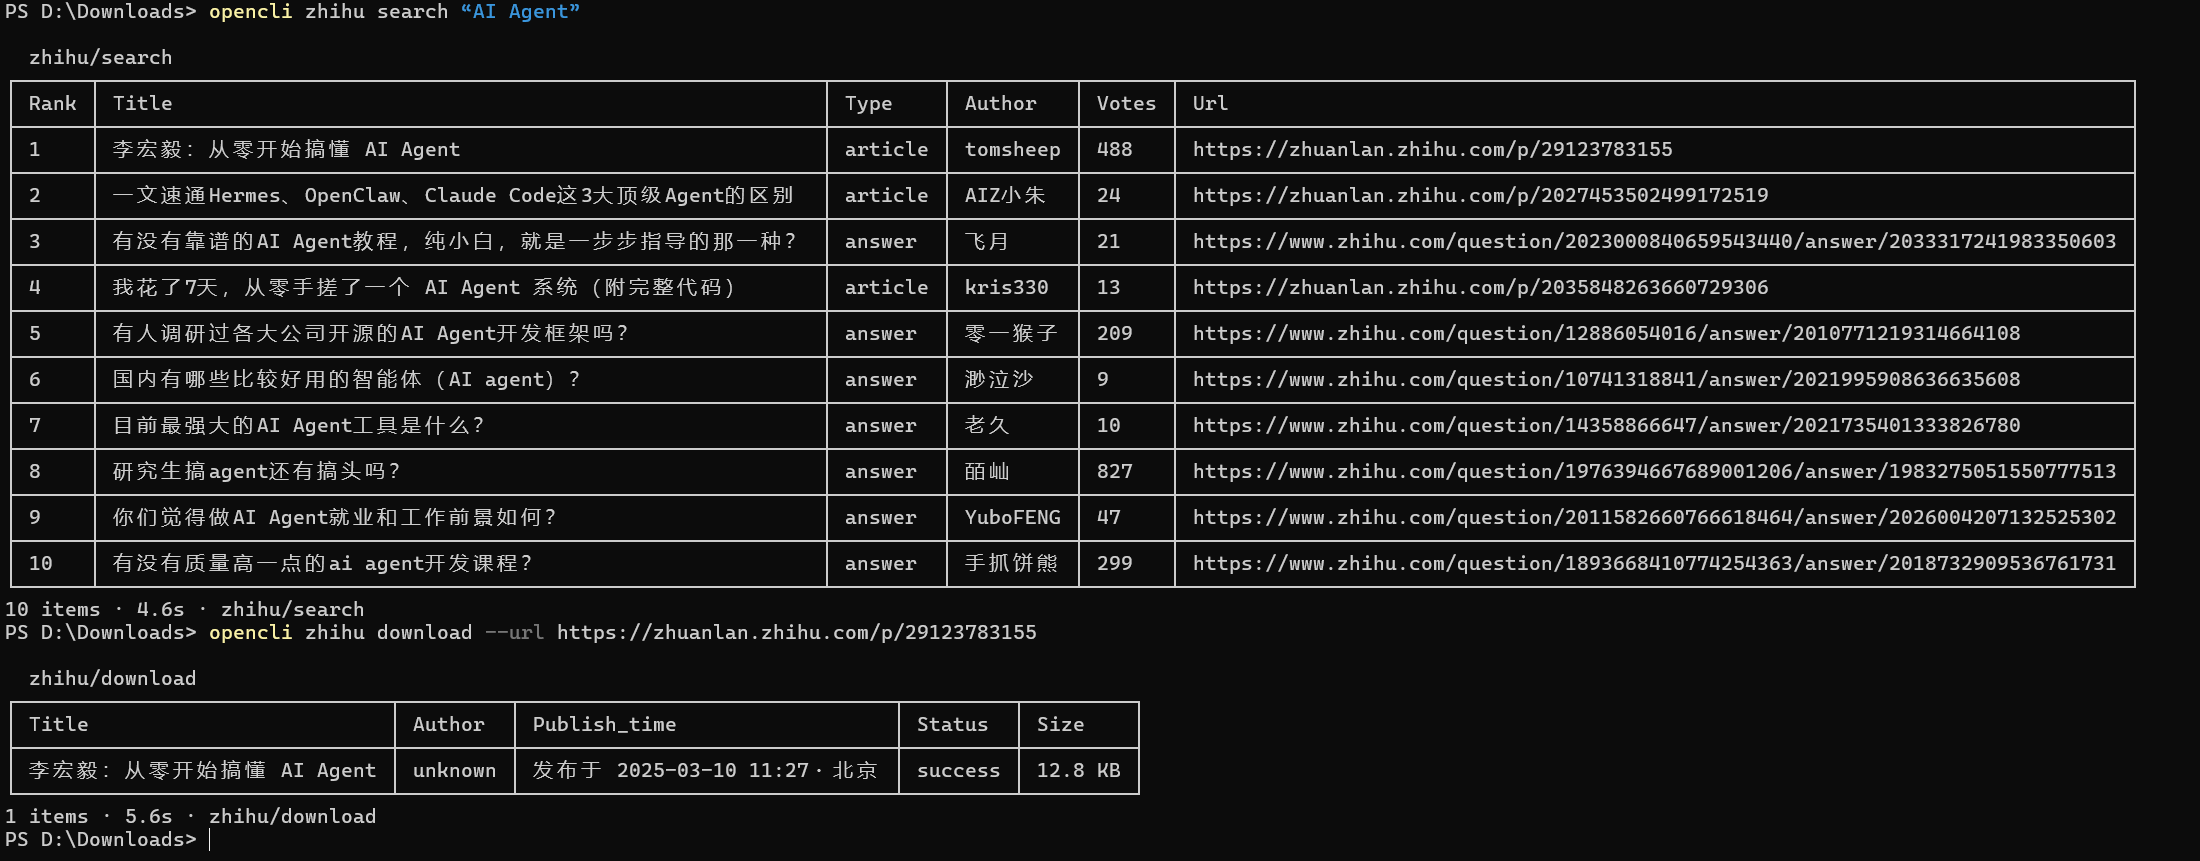
# 搜索并下载知乎文章
opencli zhihu search "AI Agent"
opencli zhihu download --url "文章地址" --output ./zhihu

# 下载微信公众号文章
opencli weixin download --url "https://mp.weixin.qq.com/s/xxxxxxxx"
下载地址默认是终端当前所在的文件夹。--output 可以指定输出目录,文章一般会导出成 Markdown,方便后续整理。
视频下载需要先装 yt-dlp。OpenCLI 复用了你的登录态,所以能拿到比未登录更高的画质。B 站下载命令后面跟的是 BV 号,不是完整网址:
opencli bilibili download BV17KdABGEDG
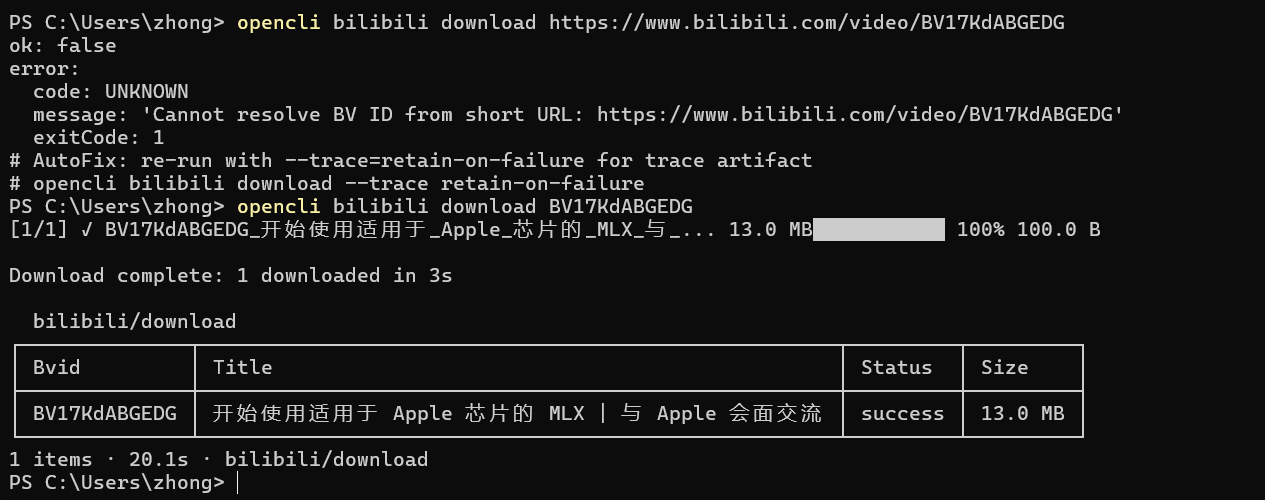
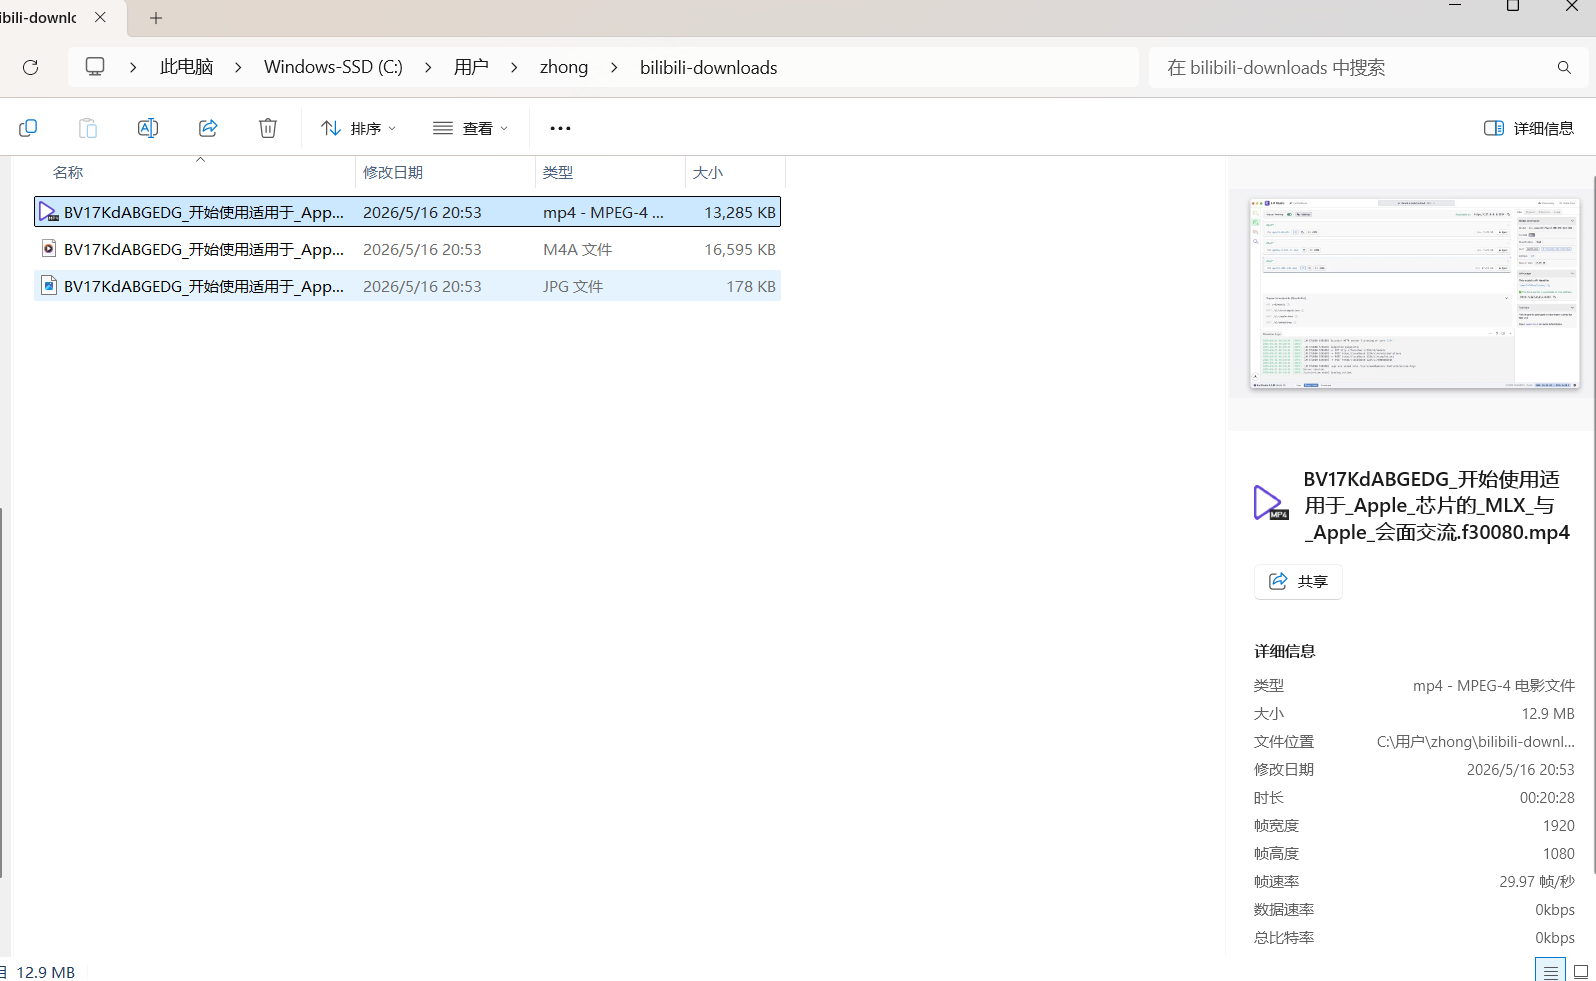
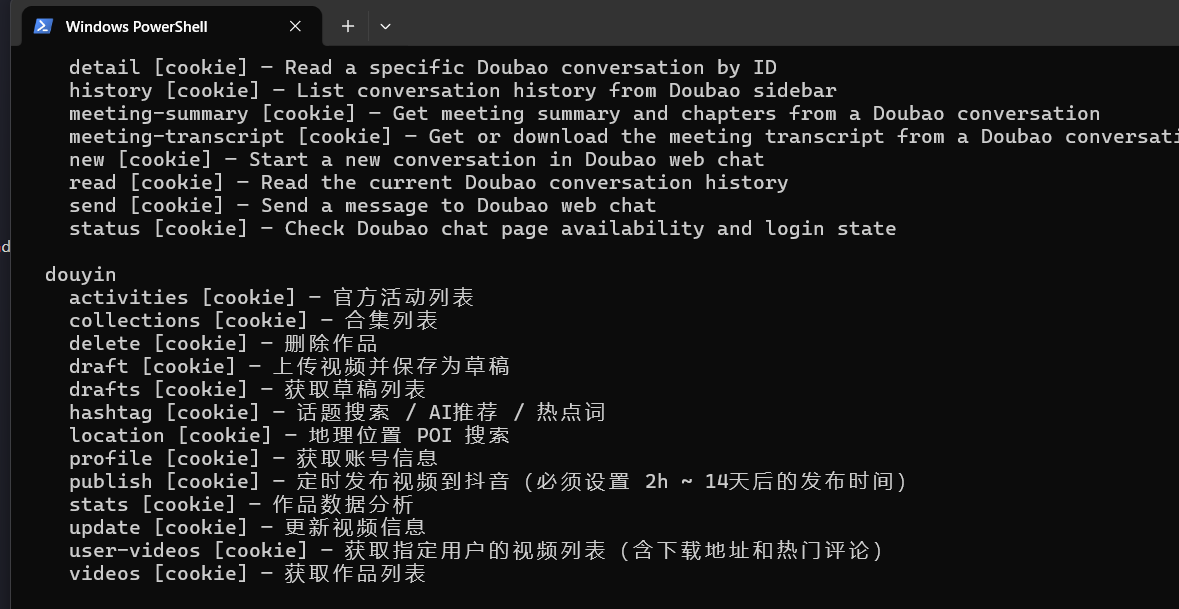
抖音有些视频没有下载按钮,OpenCLI 也可能能下载;获取指定用户时要用主页网址里的 sec_id,不是抖音号。图文类内容目前支持不完整,具体以你安装的版本为准。
微信聊天记录导出
微信桌面端有独立的 wx-cli:
npm install -g @jackwener/wx-cli
首次使用需要初始化:
wx init
它会自动检测微信数据目录,并从微信进程内存里扫描数据库密钥。这个过程需要管理员权限,而且微信必须处于登录状态。初始化完成后可以查看会话和历史记录:
wx session
wx history
OpenCLI 也在打通 Telegram、Discord 等聊天记录。把公域和私域的数据放在一起,才有机会建立真正的“个人信息流”。
但这类功能涉及隐私边界,使用前要想清楚:只处理自己的数据、只在本地使用、不要批量导出他人信息。
适配器与桌面应用
OpenCLI 内置了不少站点适配器,覆盖知乎、B 站、小红书、豆瓣、贴吧、Twitter/X、HackerNews、Pixiv 等平台,也能搜 Google Scholar 和百度学术。官方介绍里提到 100+ 站点适配器,具体数量以你安装的版本为准。
如果某个网站没有适配器,可以用 opencli-adapter-author Skill 让 Agent 帮你写:
npx skills add jackwener/opencli --skill opencli-adapter-author
还可以用 record 命令去逆向一个网站,给还没有适配器的站点生成适配器;opencli plugin install 则可以一键安装别人写好的适配器。
通过 CDP 协议,OpenCLI 还能直接操控 Electron 桌面应用的界面,不需要手动点鼠标。比如 Cursor 的 Composer、ChatGPT 的 macOS 桌面端、Notion 的页面读写、Codex CLI 的无头驱动、Discord 桌面端的消息操作,都可以纳入同一套命令体系。
个人信息流
OpenCLI 真正有意思的地方,不是单条命令,而是它能参与一整条信息流。
我现在的一个习惯是:看到值得读的公众号文章,先转发到文件助手,然后用 OpenCLI 批量导出成 Markdown,再让 Agent 做分类、摘要和标签。如果文章比较多,还可以生成一个高密度的 HTML 速览页,想细看的地方再点进去。
这套流程可以继续扩展:
- 列出你长期关注的公众号或站点;
- 每天定时抓取更新;
- 让 Agent 按主题分类、去重、摘要;
- 输出到本地知识库,或者生成每日阅读清单。
Token 成本主要花在“分析结果”这一步,抓取本身不消耗模型推理。如果只是保存和分类,成本很低;如果每篇都要深度总结,就要控制数量,或者用订阅制而不是按量计费的 API。
文献检索
AI 找文献最大的问题是幻觉:它可能编出一个看起来很像真的标题、作者和 DOI。
OpenCLI 的思路可以缓解这个问题:让模型给出检索关键词,然后通过命令去真实站点检索、下载,模型只负责整理已经拿到的结果。这样至少文献是真实存在的,剩下的判断可以人工复核。
具体流程可以是:
- 让 Agent 生成中英文关键词;
- 用 OpenCLI 在 Google Scholar、百度学术等站点检索;
- 下载 PDF 或导出元数据;
- 导入 Zotero,再做摘要和笔记。
如果不想自己搭流程,也可以看看 ustc-ai4science/academic-search 这类现成的 Skill。它的工科内容偏少,但思路是一样的:内置检索程序,让模型负责关键词和整理。
检索到的文献怎么读、怎么记,后面会单独整理。
使用边界
OpenCLI 很好用,但不是万能爬虫:
- 站点适配器可能随页面改版失效;
- 登录态、验证码、频率限制仍然存在;
- 某些平台的使用条款可能不允许自动化抓取;
- 私域数据的访问和部署属于个人行为,需要自己评估合规和隐私边界;
- 工具版本变化很快,旧命令可能对不上新版本。
我的建议是:只处理自己有权访问的数据,控制频率,不要批量抓取他人隐私,不要把敏感数据上传到第三方服务。工具越方便,越需要自己划边界。
OpenCLI 的意义,是把浏览器自动化从“让模型猜”拉回到系统调用。Agent 需要的不只是更聪明的大脑,也需要更顺手的手脚。
LLM 负责思考和决策,CLI 负责执行和获取数据。
Enjoy Reading This Article?
Here are some more articles you might like to read next: